76 моделей, одна задача: написать полноценное веб-приложение с нуля по текстовому заданию. Vibe Code Bench v1.1 от Vals.ai — пожалуй, самый честный бенчмарк ИИ кодинга на сегодня. Результаты по состоянию на 31 июля 2026 года неожиданны даже для тех, кто следит за отраслью.
Что вообще измеряет Vibe Code Bench
Большинство бенчмарков кодинга проверяют, умеет ли модель написать функцию или решить алгоритмическую задачку. Vibe Code Bench устроен иначе. Vals.ai ставит модели задачу целиком: получи текстовое описание на естественном языке, построй работающее веб-приложение, подключи реальные сервисы — Supabase, Stripe в тестовом режиме, email, браузер, файловое редактирование. Затем автоматически проверяется, работает ли приложение end-to-end.
Это, по сути, simulation продакшн-среды. Не «напиши сортировку», а «сделай продукт». Разница принципиальная. И именно поэтому верхушка таблицы так сильно отличается от нижней — там настоящая пропасть, а не градуировка.
Для тех, кто занимается практическими проектами в стиле vibe coding, такой подход куда информативнее, чем академические тесты на алгоритмы.
Лидерборд: цифры, которые удивляют
На 31 июля 2026 года в публичном снимке лидерборда 76 моделей. Первое место у Claude Fable 5 от Anthropic — 90.35%. Второй идёт Claude Opus 5 с результатом 88.40%. Третий — Kimi K3 от Moonshot AI, 84.96%.
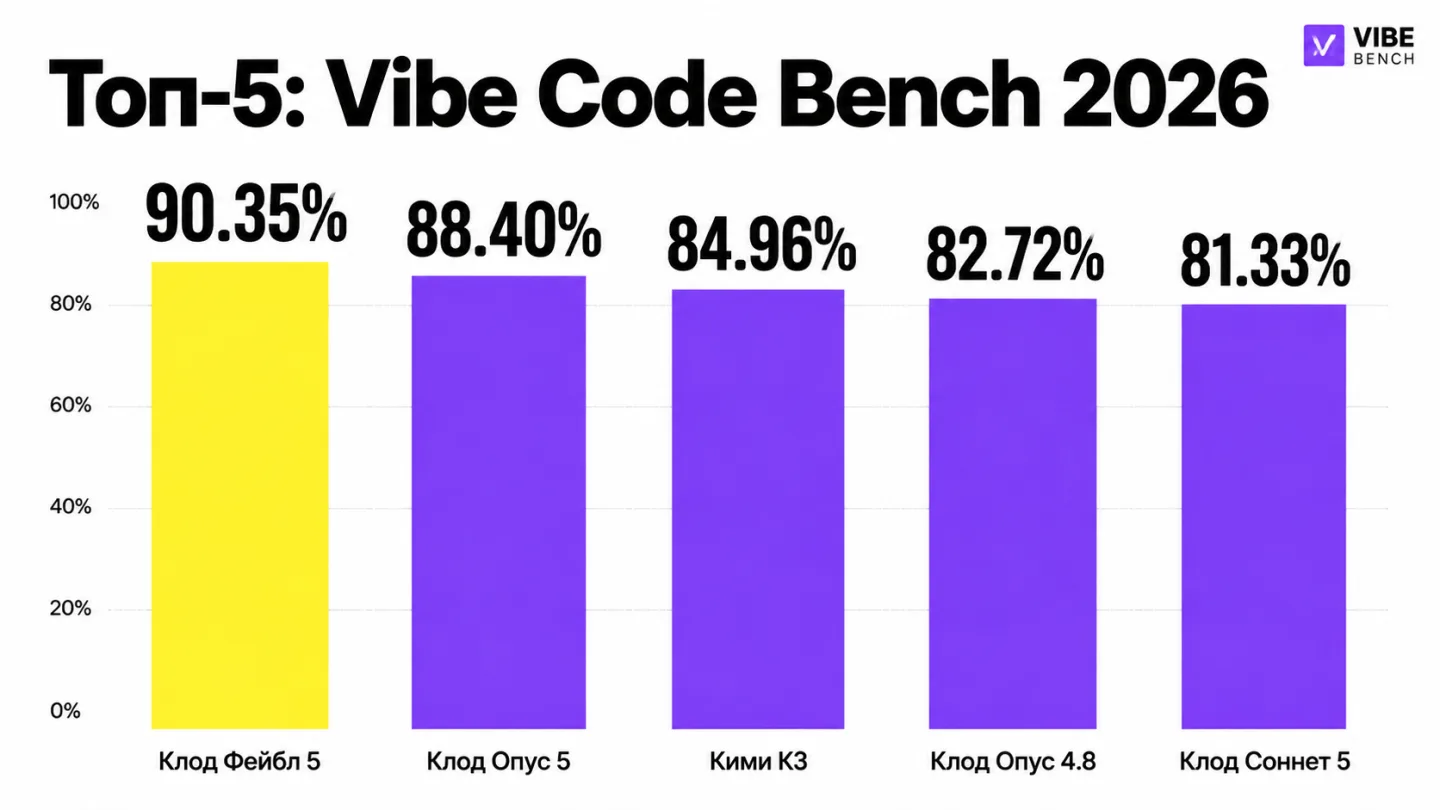
Разрыв между первым и третьим местом — всего 5.39 процентного пункта. А вот диапазон первой десятки уже 19.35 пункта: на десятом месте Claude Opus 4.7 с результатом 71.00%. Это уже заметная дистанция.
Дальше вниз по таблице цифры падают круто. GPT-5.5 на 11-м месте — 69.85%. Grok 4.5 от xAI — 69.00%. А ещё через несколько позиций идут модели с результатами ниже 30%, а нижние строчки таблицы — Mistral Small 2603, Grok 4 Fast Reasoning, Gemini 3.1 Flash Lite Preview — показывают 0.00%. Буквально ноль.
Антропик доминирует, но не монополизирует
Пять из десяти лучших позиций занимают модели Anthropic. Это много. Но присутствие Kimi K3 от Moonshot AI на третьем месте (84.96%) — сигнал, что китайские лаборатории уже не просто догоняют, а полноценно конкурируют в самой сложной категории.
OpenAI в топ-10 появляется только с GPT-5.6 Sol — 80.50%, шестое место. Забавно, что это модель с суффиксом Sol, а не просто GPT-5.6: дифференциация внутри одной серии нарастает у всех вендоров, и лидерборд это хорошо показывает.
Где провалились «думающие» модели
Один из самых нелогичных результатов: Claude Opus 4.6 Thinking на 23-м месте с 53.50% — при том, что Claude Opus 4.6 без thinking на 19-м с 57.57%. Режим «думать долго» не помог, скорее немного навредил. Похожая картина с другими thinking-версиями в нижней части таблицы.
Это не первый раз, когда extended reasoning проигрывает прямому действию в задачах полного цикла. Для бенчмарка ИИ кодинга, где нужно не рассуждать, а строить, это, честно говоря, логично.
Как читать эти данные: контекст важен
BenchLM.ai, где опубликован этот снимок лидерборда, честно указывает: Vibe Code Bench v1.1 отображается только для справки и не участвует в общей системе ранжирования платформы. Набор задач приватный, данные обновляются раз в квартал. Последнее обновление — 31 июля 2026 года, подтверждено 23 новых релиза за предшествующие 30 дней.
Это значит: лидерборд отражает реальную расстановку сил на конкретную дату, но модели выходят быстро. Снимок актуален, пока не вышла следующая генерация.
Meta неожиданно тихая
Muse Spark 1.1 от Meta — девятое место, 72.16%. Неплохо. Но исходная версия Muse Spark на 50-м с 19.67% — пропасть между поколениями одной линейки. Видимо, v1.1 был серьёзно переработан.
Интересен и Composer 2.5 от Cursor — 49.61% на 26-м месте. Это инструмент, заточенный под кодинг-среду Cursor, и тем не менее он проигрывает Claude Fable 5 почти вдвое. Специализация не всегда бьёт общий уровень.
Что это значит для практики
Команды, которые строят реальные продукты с AI, получают от таких результатов вполне прикладную информацию. Если вы выбираете модель для генерации полноценного веб-приложения по описанию — разница между первым и двадцатым местом в этой таблице принципиальная. Это не 5-10%, это иногда 40 пунктов.
Когда мы строим автоматизации с генерацией контента через Claude, выбор версии модели влияет на результат ощутимо — особенно в задачах, где нужно не просто написать текст, а выстроить логику приложения целиком.
Почему бенчмарк ИИ кодинга такого типа важен для бизнеса
Для корпоративных команд цифры из Vibe Code Bench — один из немногих ориентиров, который проверяет модели на реальных задачах, близких к боевым. Не «решить задачу с LeetCode», а «построить приложение с платёжной интеграцией и базой данных».
Для разработчиков и маркетологов, которые используют AI-инструменты для автоматизации контента и сайтов, это сигнал: не все модели одинаково полезны для сложных сценариев. Топ таблицы — это одни возможности, середина — другие, нижняя треть — практически нулевые результаты в end-to-end задачах.
Разумеется, один бенчмарк не закрывает всю картину. Latency, стоимость на запрос, поведение в edge-кейсах — всё это за рамками одной таблицы. Vals.ai публикует метаданные по задержке и стоимости теста, но в публичном снимке эти данные доступны не по всем строкам.
Итог: что взять из этих данных
На июль 2026 года Claude Fable 5 лидирует в бенчмарке ИИ кодинга для полноценных веб-приложений с результатом 90.35%. Разрыв с ближайшим преследователем небольшой, но дальше вниз по таблице — резкое падение. 76 моделей, и только единицы реально справляются с end-to-end задачей на уровне выше 80%.
Для тех, кто принимает решения о стеке AI-инструментов в своих проектах — это не просто цифры для статьи. Это практический ориентир. Если вы хотите разобраться, как перевести такие результаты в конкретные решения для вашего бизнеса, AI агентство Fabio De Luca занимается именно этим: от выбора моделей до внедрения готовых решений.