Британский стартап Inherent, основанный выходцами из Google DeepMind, выпустил агента Faraday, который самостоятельно воспроизводит результаты научных статей точнее флагманских систем Anthropic и OpenAI. Секрет – не размер модели, а подход к обучению.
Представьте: небольшая команда из дюжины человек в лондонском Кингс-Кросс строит ИИ-учёного, который умеет работать с научными данными лучше, чем многомиллиардные модели от OpenAI и Anthropic. Звучит самонадеянно. Но 22 августа 2026 года Inherent опубликовал результаты, которые заставляют отнестись к этому серьёзно.
Что такое Faraday и зачем он воспроизводит чужие статьи
Агент получил имя в честь Майкла Фарадея – физика, который ставил эксперименты без университетского образования, полагаясь на интуицию и методичность. Задача Faraday: взять опубликованную научную статью и самостоятельно воспроизвести её результаты, не зная заранее правильного ответа.
Это не случайный выбор задачи. Соучредитель и главный учёный компании Эдвард Хьюз объяснил логику просто: «Многие аспиранты начинают именно с этого». Воспроизведение чужих экспериментов – стандартная тренировка для молодых исследователей. Если агент справляется с ней на уровне опытного учёного, это уже не просто демонстрация технологии.
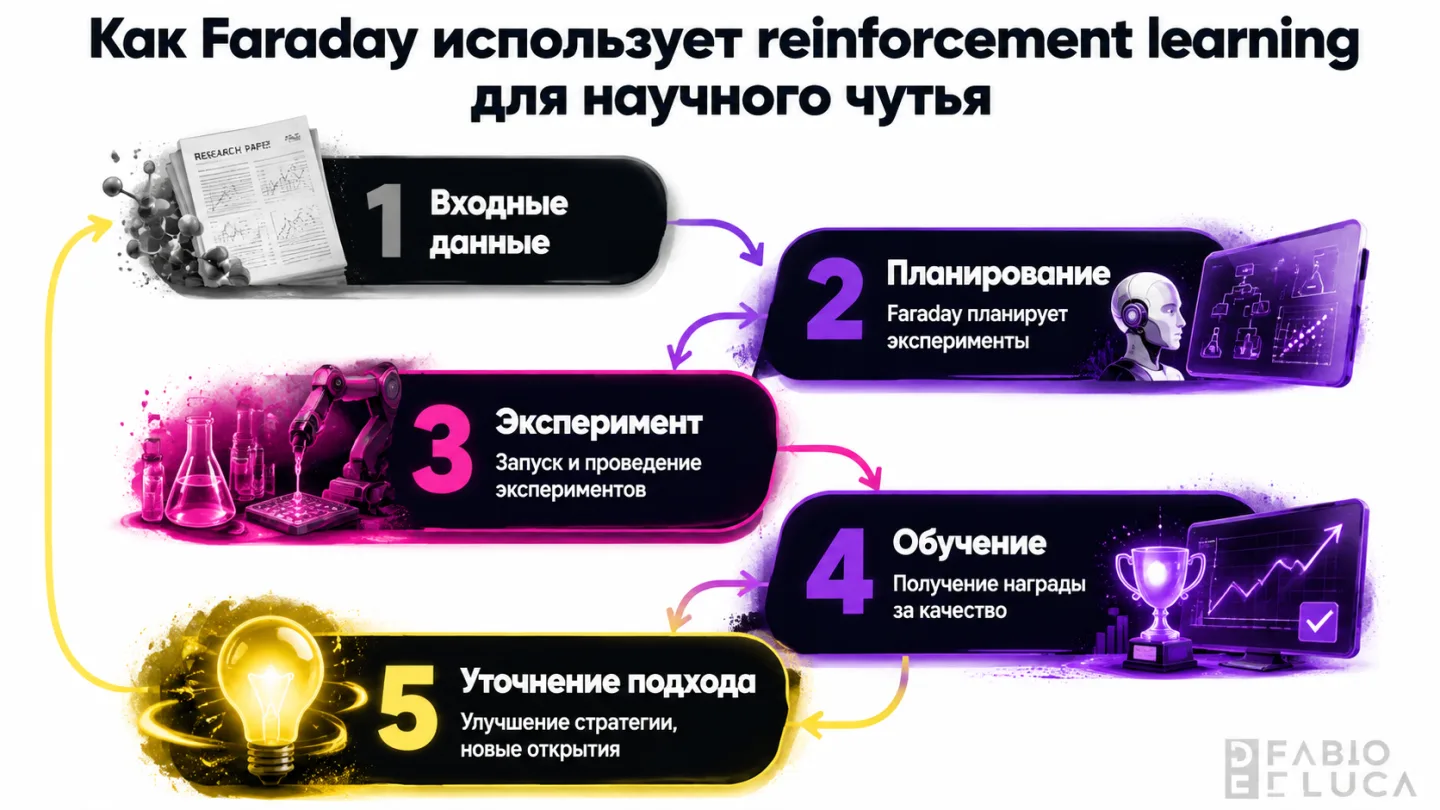
При этом Inherent поставил планку выше простой точности. Команда хотела, чтобы Faraday демонстрировал то, что они называют «research taste» – чутьё на то, какие эксперименты стоит проводить и как их грамотно выстраивать. Обучить чему-то настолько неосязаемому через правила невозможно. Здесь и появляется обучение с подкреплением (reinforcement learning): система получает вознаграждение за хорошие результаты, а не следует жёстким инструкциям.
Цифры, которые удивляют
Faraday работает на модели Qwen 3.6 с 27 миллиардами параметров. Для сравнения: Claude Opus 4.8 и GPT-5.5, которых он обошёл в тестах, – это frontier-scale системы на порядок крупнее. Параметры – грубый, но понятный прокси для размера модели и, как правило, стоимости её обучения. Меньше параметров обычно означает дешевле и быстрее.
Хьюз намеренно сместил акцент: «Нас интересовал не столько сам факт превосходства над этими агентами – хотя нам, конечно, это понравилось, – сколько то, каким путём мы к этому пришли». Это честная оговорка. Один бенчмарк – не приговор, и у крупных лабораторий есть ресурсы для быстрого ответа. Но сам принцип – достичь лучшего результата через умный подход к обучению, а не через масштаб – заслуживает внимания.
Использование ИИ для научных исследований через специализированных агентов – это другая ставка, чем гонка за размером foundation model. Inherent явно делает именно эту ставку.
Как устроен агент изнутри
Чужой инструмент вместо своего
Любопытное решение: для написания кода Faraday использует GPT-5.5 Codex от OpenAI. То есть Inherent взял инструмент конкурента и встроил его в свой агент. Хьюз объясняет это аналогией с учёными-людьми: исследователи не пишут с нуля весь программный код – они берут готовые библиотеки и инструменты. Прагматика важнее принципов.
Это решение также говорит о приоритетах команды. Они не тратят ресурсы на то, что уже хорошо сделано другими. Вместо этого концентрируются на том, что считают своим преимуществом: обучении агентов с научным чутьём через reinforcement learning. В разработке автономных ИИ-агентов такой подход – выбор правильной специализации вместо попытки закрыть всё – часто оказывается выигрышным.
Агент как коллега, а не оракул
Хьюз описывает идеальное поведение Faraday через образ любимого типа коллеги: тот, кто возвращается и говорит: «Мне стало любопытно, я провёл эти эксперименты – что думаешь о результатах?» Это принципиально отличается от агента, который просто выдаёт то, что хочет услышать пользователь.
Разница тонкая, но важная. Система, которая подтверждает гипотезы исследователя, бесполезна для науки. Система, которая самостоятельно генерирует и проверяет гипотезы, – это уже другой разговор. Именно здесь лежит граница между умным поисковиком и настоящим ИИ для научных исследований.
Кто стоит за Inherent
Четыре сооснователя – Эдвард Хьюз, Луи Кирш, Калоян Алексиев и Тантум Коллинз – все пришли из Google DeepMind. Компания вышла из стелс-режима несколько недель назад с посевным раундом в 50 миллионов долларов. Сейчас в команде 12 человек, все работают очно в офисе в Кингс-Кросс. До конца 2026 года Inherent планирует вырасти до 20-25 сотрудников.
Хьюз открыто поддерживает отмену «garden leave» – британской практики, при которой уволившийся сотрудник не может несколько месяцев работать у конкурента. Сам он столкнулся с этим ограничением лично. Американские исследователи такого барьера не имеют, что даёт стартапам из США фору при найме. Это не просто личная позиция: для молодого лондонского ИИ-стартапа, конкурирующего за таланты с DeepMind и американскими лабораториями, вопрос найма – вопрос выживания.
Большая цель: ИИ-учёный, который делает открытия
Воспроизведение чужих результатов – это тренировка, не финал. Inherent прямо говорит, что конечная цель – агент, способный самостоятельно совершать научные открытия, а не только верифицировать уже известное. Это амбиция другого порядка.
Путь туда долгий. Но логика понятна: сначала научить агента точно воспроизводить эксперименты других, потом – комбинировать методы из разных областей, потом – ставить собственные вопросы. Именно поэтому команда делает ставку на reinforcement learning, а не на обучение агентов тому, «как устроена наука» через тексты. Reward-based подход, по их расчёту, лучше обобщается на новые научные области.
Посмотреть на практические кейсы разработки ИИ в других сферах полезно: там видна та же закономерность – специализированные агенты с правильно настроенным обучением часто превосходят универсальные системы на конкретных задачах.
Что это значит для рынка ИИ-решений
История Inherent ставит неудобный вопрос для крупных лабораторий: если 27-миллиардная модель с умным обучением обходит frontier-системы на специализированной задаче, зачем платить за огромные универсальные модели там, где нужна конкретная функция?
Ответ, конечно, не однозначный. Frontier-модели выигрывают на широте задач. Но тренд на специализацию агентов набирает силу – и Faraday это подтверждает. Для бизнеса, который строит решения на базе искусственного интеллекта, это сигнал: выбор правильной архитектуры и метода обучения под конкретную задачу может дать больше, чем просто доступ к самой большой модели на рынке.
Inherent пока маленький стартап с большими претензиями. Один бенчмарк по воспроизведению научных статей – это не доказательство того, что ИИ-учёный уже здесь. Но направление мысли интересное, деньги есть, команда сильная. Следующий шаг – показать, что Faraday умеет не только повторять, но и удивлять. Если это случится, разговор о применении ИИ для научных исследований выйдет на совершенно другой уровень конкретности.
А пока – стоит следить. Лондонский Кингс-Кросс становится всё более интересным местом на карте мировой ИИ-разработки, и Inherent – одна из причин почему.