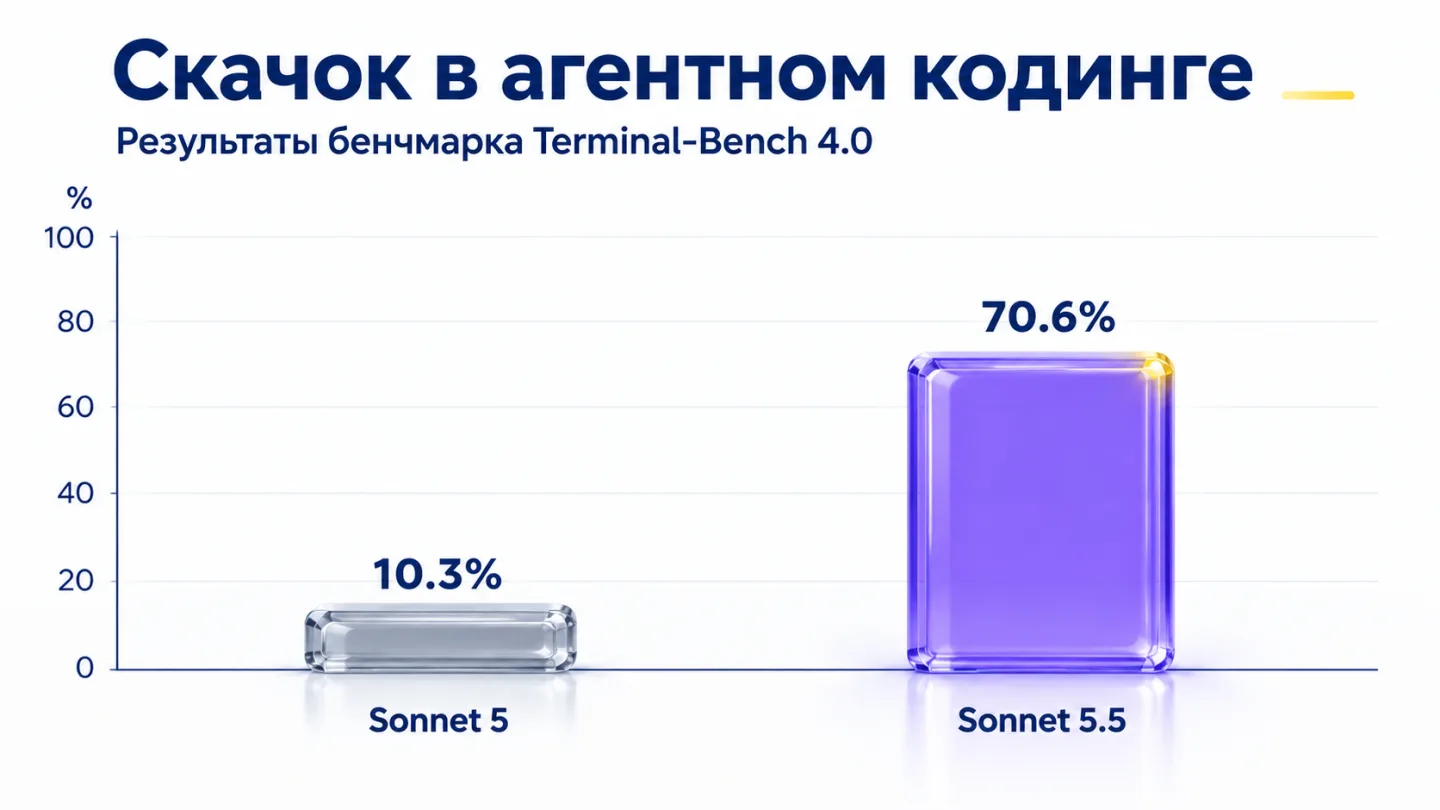
Anthropic представила Claude Sonnet 5.5 — вторую модель линейки Claude 5.5. Компания заявляет о приросте скорости более 30% и снижении стоимости выполнения задач до 30% по сравнению с Sonnet 5, а на бенчмарке агентного программирования Terminal-Bench 4.0 новая модель набрала 70,6% против 10,3% у предшественника.
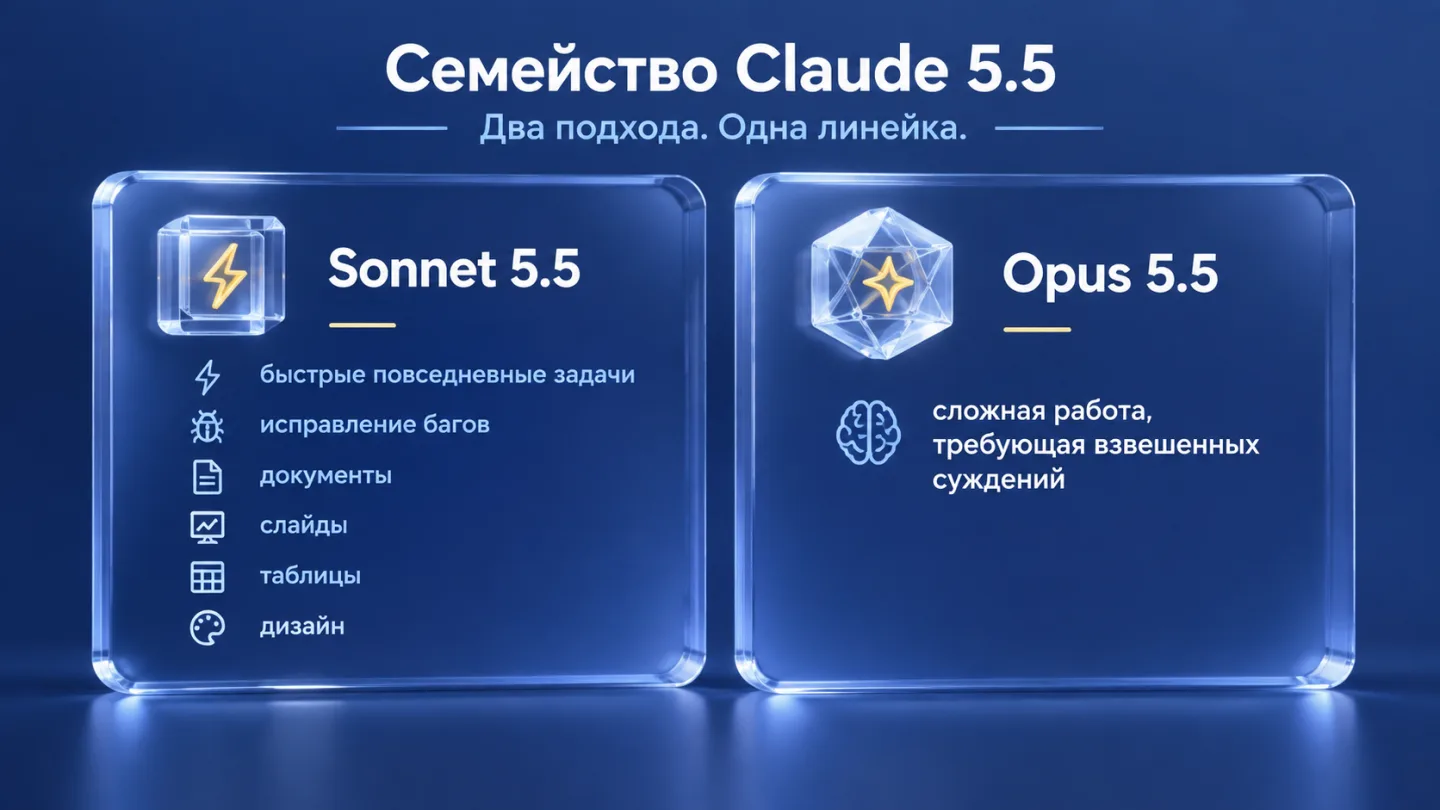
28 сентября 2026 года Anthropic анонсировала Claude Sonnet 5.5. Это вторая модель в семействе Claude 5.5, явное улучшение по сравнению с Claude Sonnet 5, которое работает более чем на 30% быстрее и стоит до 30% дешевле для большинства задач. По собственному позиционированию компании, Sonnet 5.5 служит более быстрым и дешёвым дополнением к Claude Opus 5.5.
Роли между моделями разведены довольно чётко. Opus 5.5 предназначена для сложной работы, требующей взвешенных суждений, тогда как Sonnet 5.5 сильнее всего проявляет себя в чётко очерченных повседневных задачах, исправлении багов и создании готовых документов, презентаций и таблиц. Отдельно Anthropic отмечает, что у модели острый глаз на дизайн. Через несколько недель линейку дополнит ещё одна модель: Claude Haiku 5.5, созданная для высоконагруженных и чувствительных к цене приложений, присоединится к семейству Claude 5.5 в ближайшие недели.
Главный скачок — агентное программирование
Самая заметная цифра в анонсе касается именно кодинга. Sonnet 5.5 набирает 70,6% на Terminal-Bench 4.0, тесте агентного программирования, тогда как у Sonnet 5 результат составлял 10,3%. Для модели, которая позиционируется как рабочая лошадка для повседневных задач, а не флагман, такой разрыв выглядит существенно. Разумеется, это данные производителя, полученные в его собственном тестировании.
На тесте реальной профессиональной работы GDPval-AA картина немного иная: модель набирает на два балла меньше, чем Opus 5.5. Это подтверждает логику разделения ролей внутри линейки: Sonnet 5.5 подбирается близко к флагману, но не заменяет его целиком. Отдельно заявлено достижение в работе с изображениями и длинным контекстом: модель сильна в долгосрочной работе и понимании изображений, это первая модель Sonnet, победившая в Pokémon Red, работая исключительно со скриншотами.
Стиль работы, цена и скорость
Anthropic описывает и качественные изменения в манере письма модели. Как и Opus 5.5, Sonnet 5.5 пишет более ясно, чем предыдущее поколение моделей компании, а ранние тестировщики называли её более удачным партнёром для совместной работы, чем Sonnet 5. Здесь стоит сделать оговорку: речь идёт о впечатлениях привлечённых компанией тестировщиков, а не о независимой проверке.
По цене модель формально не изменилась. Sonnet 5.5 стоит столько же, сколько Sonnet 5: 2 доллара за миллион входных токенов, 10 долларов за миллион выходных и 0,20 доллара за миллион токенов при чтении из кеша, но для выполнения той же работы ей обычно требуется заметно меньше токенов. Именно за счёт этого и получается заявленная экономия: по внутренним тестам компании, задача обходится до 30% дешевле, чем у предшественника. Со скоростью всё проще: Sonnet 5.5 генерирует ответы более чем на 30% быстрее, чем Sonnet 5, что делает её самой быстрой моделью Sonnet на сегодняшний день.
Безопасность и практические сценарии
По части соответствия внутренним стандартам безопасности Anthropic сообщает, что по результатам автоматизированного поведенческого аудита Sonnet 5.5 улучшает или сохраняет показатели Sonnet 5 по большинству параметров согласованности. Отдельно выделен пункт про кибербезопасность: поскольку возможности модели в этой области сопоставимы с Sonnet 5, это первая модель Sonnet, запущенная со средствами защиты и запасными механизмами, аналогичными тем, что разработаны для самых мощных моделей компании, при этом оба типа защитных механизмов нацелены на узкий круг запросов повышенного риска, а обычная разработка ПО и большая часть работы в сфере наук о жизни не затрагиваются. Если заявленные показатели агентного кодинга и снижения стоимости подтвердятся на практике, у бизнеса появится повод пересмотреть, какие рутинные задачи разработки и документооборота стоит передать модели уровня Sonnet, а какие оставить за более дорогим флагманом. Это гипотеза для проверки на реальных процессах компании, а не готовый вывод. Для команд, которые уже строят рабочие процессы вокруг AI-агентов для бизнеса, обновление модели в стеке — обычный повод протестировать сценарии заново, от автоматизации кода до генерации документов. Полезным дополнением может стать и обучение сотрудников AI, чтобы команда умела оценивать подобные обновления не по маркетинговым цифрам, а по результатам на своих задачах.